고객 평가 화면과 인계 자료
고객이 모델별 답변과 후속 질문을 비교할 수 있는 평가 환경을 마련하고, API 명세·단계별 연동 가이드·성능 검증 자료·사용 안내를 정리했습니다.
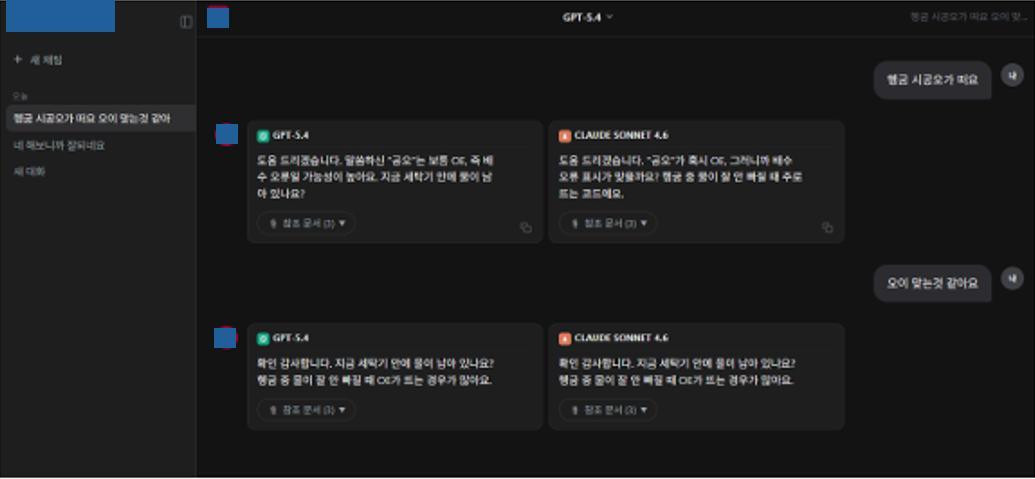
고객 식별 정보를 가린 평가 화면입니다. 같은 질문에 대한 응답과 후속 대화, 참고 문서를 함께 확인할 수 있습니다.
크게 보기 — 모델별 답변과 대화 맥락 비교 (새 탭) ↗화면은 평가 방법을 보여주는 자료입니다. 테스트 지표의 정의와 최종 진행 결과는 아래 검증 자료에 구분해 정리했습니다.
챗봇·콜봇 시스템 구성
1차 웹 챗봇과 2차 콜봇 API를 각각의 구현 기준으로 정리했습니다.
01 · 단계별 아키텍처
웹 챗봇 · 콜봇 API
웹 챗봇은 SSE로 답변을 순차 전달합니다. 콜봇 API는 캐시 또는 RAG 결과를 JSON으로 반환합니다. 두 영역은 별도 단계의 구현입니다.
구현 메모 및 출처
- 1차는 FAISS·BM25 하이브리드 검색과 문서 관련성 필터를 사용합니다. 2차는 캐시를 먼저 조회하고, 미적중이면 FAISS 기반 RAG로 처리합니다.
- 직접 구현한 전환 지점은 응답 형식, 대화 맥락 유지, 캐시와 RAG 폴백입니다. 고객 운영망이나 상용 배포 구성은 이 그림의 범위에 포함하지 않습니다.
1·2차 원본 저장소의 실제 웹/API 요청 경로를 2026.10.07 대조해 재구성했습니다. 비공개 고객명·플랫폼명·원본 경로는 제외했습니다.
02 · 요청 처리 흐름
콜봇 캐시 조회 순서
정확 매칭 → 유사 매칭 → 대화 궤적 순으로 조회합니다. 적중하면 저장 답변을 반환하고, 모두 미적중이면 RAG를 실행합니다.
구현 메모 및 출처
- 대화 궤적 캐시에는 RAG가 생성한 답변도 추가됩니다. 사람이 모두 검증한 정답 저장소라는 의미는 아닙니다.
- 캐시 경로에서도 임베딩 호출이 발생할 수 있습니다. 이 구조만으로 모든 요청의 지연이나 정확도를 보장하지 않습니다.
- 지원 범위 밖 질문의 고정 응답, 테스트용 캐시 우회, 타임아웃·예외 처리는 가독성을 위해 생략했습니다.
2차 콜봇의 요청 핸들러·캐시 조회·검색·생성 호출 관계를 기준으로 재구성했습니다. 내부 키·저장 스키마·고객 데이터는 표시하지 않았습니다.
대기업 고객사의 상담 자동화 PoC를 1차 챗봇부터 2차 콜봇 API까지 단독 수행했습니다. 스트리밍 화면에서 검증하던 RAG를 동기 JSON 응답과 대화 맥락을 반영하는 캐시 구조로 전환했습니다.
6개 벤더가 참여한 상담 자동화 PoC에서 공식 지원 문서를 근거로 질문에 답하는 챗봇을 검증했습니다. 1차에서 2개 후보로 선정된 뒤 콜봇 플랫폼 연동을 위한 2차 고도화를 진행했습니다.
웹 챗봇은 생성 중인 답변을 스트리밍할 수 있지만 콜봇은 완성된 JSON 응답을 한 번에 받아야 했습니다. 5초 응답 목표에 맞춰 검색·생성 지연, 반복 질문, 대화 이력 처리와 API 응답 형식을 함께 검토해야 했습니다.
요구사항과 PoC 범위를 정리하고, 지원 문서 수집·인덱싱, RAG 챗봇, 평가 스크립트, 고객 테스트 환경, 콜봇 API와 캐시를 직접 구현했습니다. 1·2차 모두 단독으로 수행하며 검증 결과와 한계를 고객 전달 자료로 정리했습니다.
지원 문서 243건을 검색 가능한 데이터로 구조화하고 질문 라우팅·재작성, 검색, 답변 생성을 연결했습니다. 콜봇 전환에서는 동기 JSON API와 대화 ID를 유지하는 흐름을 구현했습니다. 동일 질문과 대화 이력의 정확 매칭, 임베딩 유사 매칭, 사전 Q&A 대화 궤적 매칭을 거쳐 캐시 미스 때 RAG를 실행하도록 구성했습니다.
기술 검증과 함께 답변 생성까지 포함하는 Full RAG와 검색 전용 구성의 두 구축 옵션을 정리했습니다. AWS·LLM 사용량에 따라 변하는 비용을 고정 구축 범위와 구분하고 견적·가격 조정안을 제안했습니다. 기술·비용·운영 조건을 함께 판단할 수 있는 자료를 만드는 것이 목적이었으며, 실제 수주로 이어진 가격 모델이라는 의미는 아닙니다.
1차에서 6개 벤더 중 2개 후보로 선정되어 2차 콜봇 연동·고도화를 완수했으나 최종 선정에는 이르지 못했습니다. 자체 검증에서는 응답 필드·형식과 대화 ID 유지 등 9개 검사 항목을 확인했습니다. 기술 구현과 검증 자료를 남긴 결과이며 상용 도입이나 수주 성과로 해석하지 않습니다.
검색은 정답 문서가 상위 후보에 포함되는 Hit@K로, API는 응답 형식과 대화 ID 유지로 검사했습니다. 멀티턴 5개 시나리오·20턴은 예상 키워드의 절반 이상 포함을 통과 기준으로 삼았고, 해당 버전에서 19/20턴, 후속 버전에서 20/20턴을 기록했습니다. 키워드 통과율은 답변 정답성이나 전체 상담 성공률과 구분해야 합니다.
평가에는 합성 질문과 지정 시나리오를 사용했습니다. 첫 질문의 응답 길이와 특정 거절 문구 유무를 검사한 지표는 정답 정확도로 사용할 수 없습니다. 동일 질문 재호출은 최초 호출보다 빨랐지만 모든 API 응답이 5초 이내였다는 근거는 없습니다. 캐시 상태와 평가 정의를 함께 보고해야 하며, 최종 미선정의 원인은 확인된 근거 없이 단정하지 않습니다.
자체 검증의 검색·키워드·응답 형식 지표를 구분합니다. 캐시 재호출 결과를 전체 응답 보장이나 정답 정확도로 사용하지 않습니다.
구현 흐름과 평가의 범위
원본 코드와 버전별 실행 기록을 바탕으로 재구성한 자료입니다. 고객 원문과 내부 시스템 정보는 포함하지 않습니다.
- 01질문·대화 맥락 확인
- 02맥락별 캐시 조회
- 03미스 시 검색·답변 생성
- 04동기 JSON 응답
| 검증 항목 | 기록에서 확인한 것 | 해석 범위 |
|---|---|---|
| 첫 질문 응답 검사 | 30개 중 29개가 길이·거절 문구 조건 통과 | 정답 정확도나 LLM 채점 결과가 아닌 휴리스틱 검사 |
| 멀티턴 회귀 검사 | 5개 시나리오 20턴: 초기 19턴, 후속 20턴 통과 | 예상 키워드 포함 여부 검사. 캐시 경로와 순수 검색 성능 미분리 |
| 응답시간 | 동일 질문 재호출 평균 2.45초인 측정 회차 존재 | 최초 호출·캐시 사용 조건에 따라 다르며 모든 요청의 5초 응답을 보장하지 않음 |
| 연동 형식 | 필드·형식과 대화 ID 유지 등 자체 9개 항목 검사 | 외부 플랫폼 통합 인증과는 구분 |
평가 코드·생성 보고서·버전별 실행 기록 대조(2026.10.07). 합성 테스트에 기반한 자체 검증이며 운영 환경의 성능을 의미하지 않습니다.